Neue Methode zur Generierung von Testfällen
Die jüngst veröffentlichte Forschungsarbeit „Certifying Repeatable Entry-Replay Witnesses for COBOL-to-Java Migration“ knüpft an den bereits vorgestellten Locksmith Loop von American Express an. Während das ursprüngliche Verfahren die deterministische Validierung migrierter Anwendungen adressierte, konzentriert sich die neue Untersuchung auf die Generierung geeigneter Testfälle. Gerade bei älteren COBOL-Anwendungen fehlten häufig ausreichende Testdaten, um das Verhalten des Ausgangscodes mit dem einer Java-Version vergleichen zu können.
Dafür setzen die Forscher auf ein Verfahren namens Backward Lifting. Ausgehend von einzelnen Programmabschnitten werden die notwendigen Eingabebedingungen rückwärts bis zum Programmeinstieg ermittelt. Externe Interaktionen, etwa Datenbankzugriffe, Dateiverarbeitung oder Subprogrammaufrufe, werden über eine chronologische Aufzeichnung (External-Operation Tape) simuliert.
Reproduzierbare Tests ohne Kundendaten
Anders als bei der vorherigen Untersuchung verwendeten die Forscher keine vorhandenen Testdaten, sondern leiteten synthetische Eingabedaten aus den COBOL-COPYBOOK-Strukturen ab. Kundendaten kamen dabei nach Angaben der Autoren nicht zum Einsatz.
Ein Testfall wird erst zertifiziert, wenn er sich unter definierten Bedingungen mit dem kompilierten COBOL-Programm reproduzieren lässt. Anschließend wird derselbe Testfall auf den generierten Java-Code angewendet. Der Vergleich erfolgt anhand festgelegter Beobachtungen, darunter Rückgabewerte, Programmabläufe und ausgewählte Datenzustände.
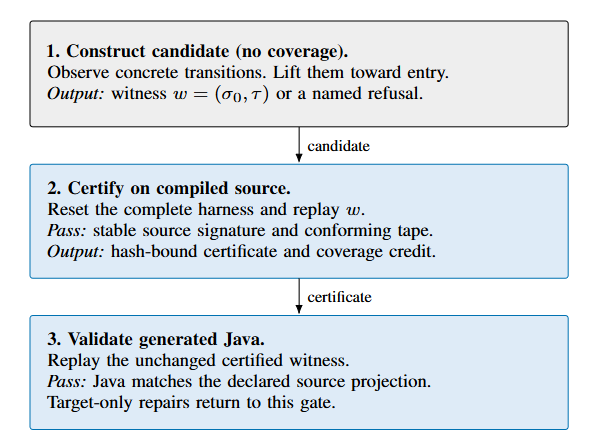
Dreistufige Validierung bei der COBOL-zu-Java-Migration: Die Forscher von American Express konstruieren zunächst synthetische Testfälle, zertifizieren deren reproduzierbare Ausführung im COBOL-Ausgangsprogramm und vergleichen anschließend das Verhalten des generierten Java-Codes anhand definierter Beobachtungen. Quelle: Ferenczi et al., Certifying Repeatable Entry-Replay Witnesses for COBOL-to-Java Migration, 2026, Abbildung 1.
849 zertifizierte Testfälle für 33.429 Zeilen COBOL
Die Forscher erprobten die Methode an einem produktionsnahen COBOL-Programm mit 33.429 Codezeilen und 1.033 Paragraphen. Damit war der untersuchte Codeumfang rund achtmal größer als bei der vorherigen Arbeit.
Insgesamt generierten sie 849 zertifizierte End-to-End-Testfälle. Diese deckten 78,1 Prozent der untersuchten Verzweigungsergebnisse (Branch Coverage) und 95,7 Prozent der Paragraphen (Paragraph Coverage) ab. Bei allen 849 Testfällen stimmte das Verhalten des generierten Java-Codes mit dem COBOL-Surrogat innerhalb der definierten Vergleichskriterien überein.
Während der Untersuchung identifizierten und korrigierten die Forscher 61 Defekte im Java-Code. Betroffen waren unter anderem die Speicherinitialisierung, die Verarbeitung von Datenlayouts, Kontrollflussanweisungen sowie numerische Operationen.
Einen quantifizierten Leistungsgewinn gegenüber der ursprünglichen Locksmith-Loop-Methode beanspruchen die Autoren ausdrücklich nicht. Dafür hätten sich die untersuchten Programme und die während der Entwicklung eingesetzten KI-Modelle und Werkzeuge zu stark unterschieden.
Fehleranalyse zeigt Grenzen der Validierung
Um die Aussagekraft der Validierung zu untersuchen, veränderten die Forscher den generierten Java-Code zusätzlich an 450 Stellen gezielt. Die Mutationen umfassten zehn Fehlertypen, darunter entfernte Schreiboperationen, veränderte Bedingungen, fehlerhafte Datenzugriffe sowie Rundungs- und Präzisionsabweichungen.
Das Prüfverfahren erkannte insgesamt 214 der 450 eingebauten Fehler (47,6 Prozent). Bei ausgeführten WRITE/REWRITE-Operationen und PERFORM-Aufrufen wurden sämtliche absichtlich eingeführten Löschungen erkannt. Von 35 erreichten Mutationen bei Rundung und arithmetischer Präzision wurde dagegen keine identifiziert. Die Autoren führen dies darauf zurück, dass die generierten Testfälle numerische Grenzwerte nur selten abdeckten.
Gerade bei Banken und Versicherungen können solche Abweichungen fachlich relevant werden, etwa bei der Zinsberechnung, der Ermittlung von Stückzinsen in der Wertpapierabwicklung oder der Berechnung von Versicherungsprämien.
Keine vollständige funktionale Gleichwertigkeit
Die Forscher weisen zudem darauf hin, dass ihre Methode keine vollständige funktionale Gleichwertigkeit im Produktivbetrieb nachweise. Die Übereinstimmung gelte ausschließlich für die zertifizierten Testfälle und die festgelegten Beobachtungspunkte. Fehlerszenarien und temporäre Speicherzustände blieben beispielsweise außerhalb des Prüfbereichs. Auch mögliche Unterschiede zwischen dem eingesetzten GnuCOBOL-Compiler und der ursprünglichen Mainframe-Umgebung seien zu berücksichtigen.
Mit der Frage geeigneter Testgrundlagen beschäftigt sich auch eine jüngst veröffentlichte Studie von Sopra Steria und französischen Forschungseinrichtungen. Sie untersucht, inwieweit sich die strukturelle Komplexität historisch gewachsener COBOL-Anwendungen synthetisch nachbilden lässt, ohne deren Funktionalität zu verändern. Während dort die Erzeugung realistischer Testprogramme im Mittelpunkt steht, setzt American Express bei der automatisierten Generierung von Testfällen für vorhandenen COBOL-Code an.
Die neue American-Express-Untersuchung dokumentiert damit einen weiteren Ansatz zur automatisierten Testfallgenerierung und Validierung bei COBOL-Migrationen. Für einen vollständigen Nachweis der funktionalen Gleichwertigkeit reichen die erzielten Ergebnisse nach Einschätzung der Autoren jedoch nicht aus. (td)