COBOL ist weiterhin in geschäftskritischen Anwendungen von Banken, Versicherungen und öffentlichen Verwaltungen im Einsatz. Gleichzeitig sind repräsentative Codebestände aus produktiven Mainframe-Anwendungen öffentlich kaum verfügbar, schreiben die Autoren der Studie „Spec2COBOLRot: An Agentic-AI Degradation Loop for Realistic COBOL Corpus Generation“. Das erschwere die belastbare Bewertung KI-gestützter Modernisierungsverfahren. Ohne realistische COBOL-Korpora ließen sich deren Fehlerbilder und Einsatzgrenzen nur schwer systematisch untersuchen.
Öffentlich verfügbare COBOL-Sammlungen lösen dieses Problem nach Einschätzung der Forscher nur bedingt. Sie seien heterogen und enthielten häufig nicht jene Strukturen, die für produktive Enterprise-Anwendungen charakteristisch seien. Dazu zählten etwa Copybooks, sequenzielle und indexierte Dateiverarbeitung oder geschäftsorientierte Kontrollflüsse. Hinzu komme, dass produktive COBOL-Codebasen in der Regel proprietär seien.
Erst sauberer COBOL-Code, dann künstliche Alterung
Mit dem Forschungsansatz Spec2COBOLRot versuchen Jean-Baptiste Espinasse, Djamel Eddine Khelladi und Mathieu Acher deshalb, geeigneten Testcode synthetisch herzustellen. Das Verfahren besteht aus zwei Schritten. Zunächst erzeugt ein KI-Agent aus einer natürlichsprachlichen fachlichen Spezifikation ein COBOL-Programm. Dieses wird mit GnuCOBOL kompiliert und mit synthetischen Daten ausgeführt. Fehler bei Kompilierung oder Ausführung werden an den Agenten zurückgegeben, der das Programm überarbeitet.
Im zweiten Schritt wird der zunächst vergleichsweise saubere Code gezielt verändert. Grundlage dafür ist eine Bibliothek mit Mustern, die aus realem Produktionscode abgeleitet wurde. Sie enthält 26 sogenannte Assets: acht typische COBOL-Idiome, 15 Code-Smells sowie drei „Mismatches“, also COBOL-spezifische Konstrukte, die bei einer späteren Modernisierung eine nicht triviale Anpassungsentscheidung erfordern. Als Beispiele nennt die Studie unstrukturierte GO TO-Abläufe, überdimensionierte Working-Storage-Bereiche, die Vermischung von Ein-/Ausgabe und Geschäftslogik, Memory-Overlay-Strukturen und Packed-Decimal-Darstellungen.
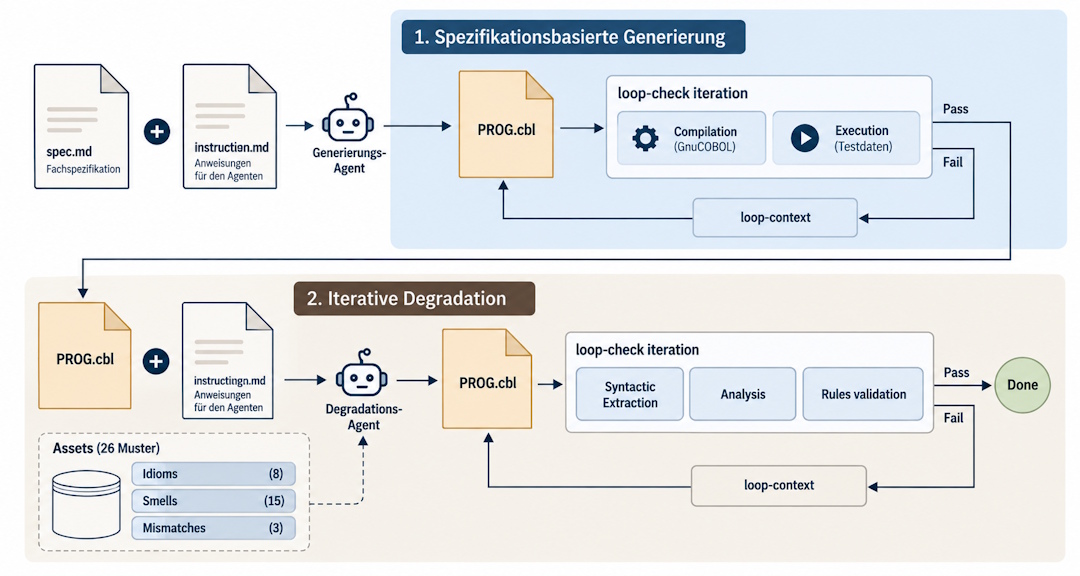
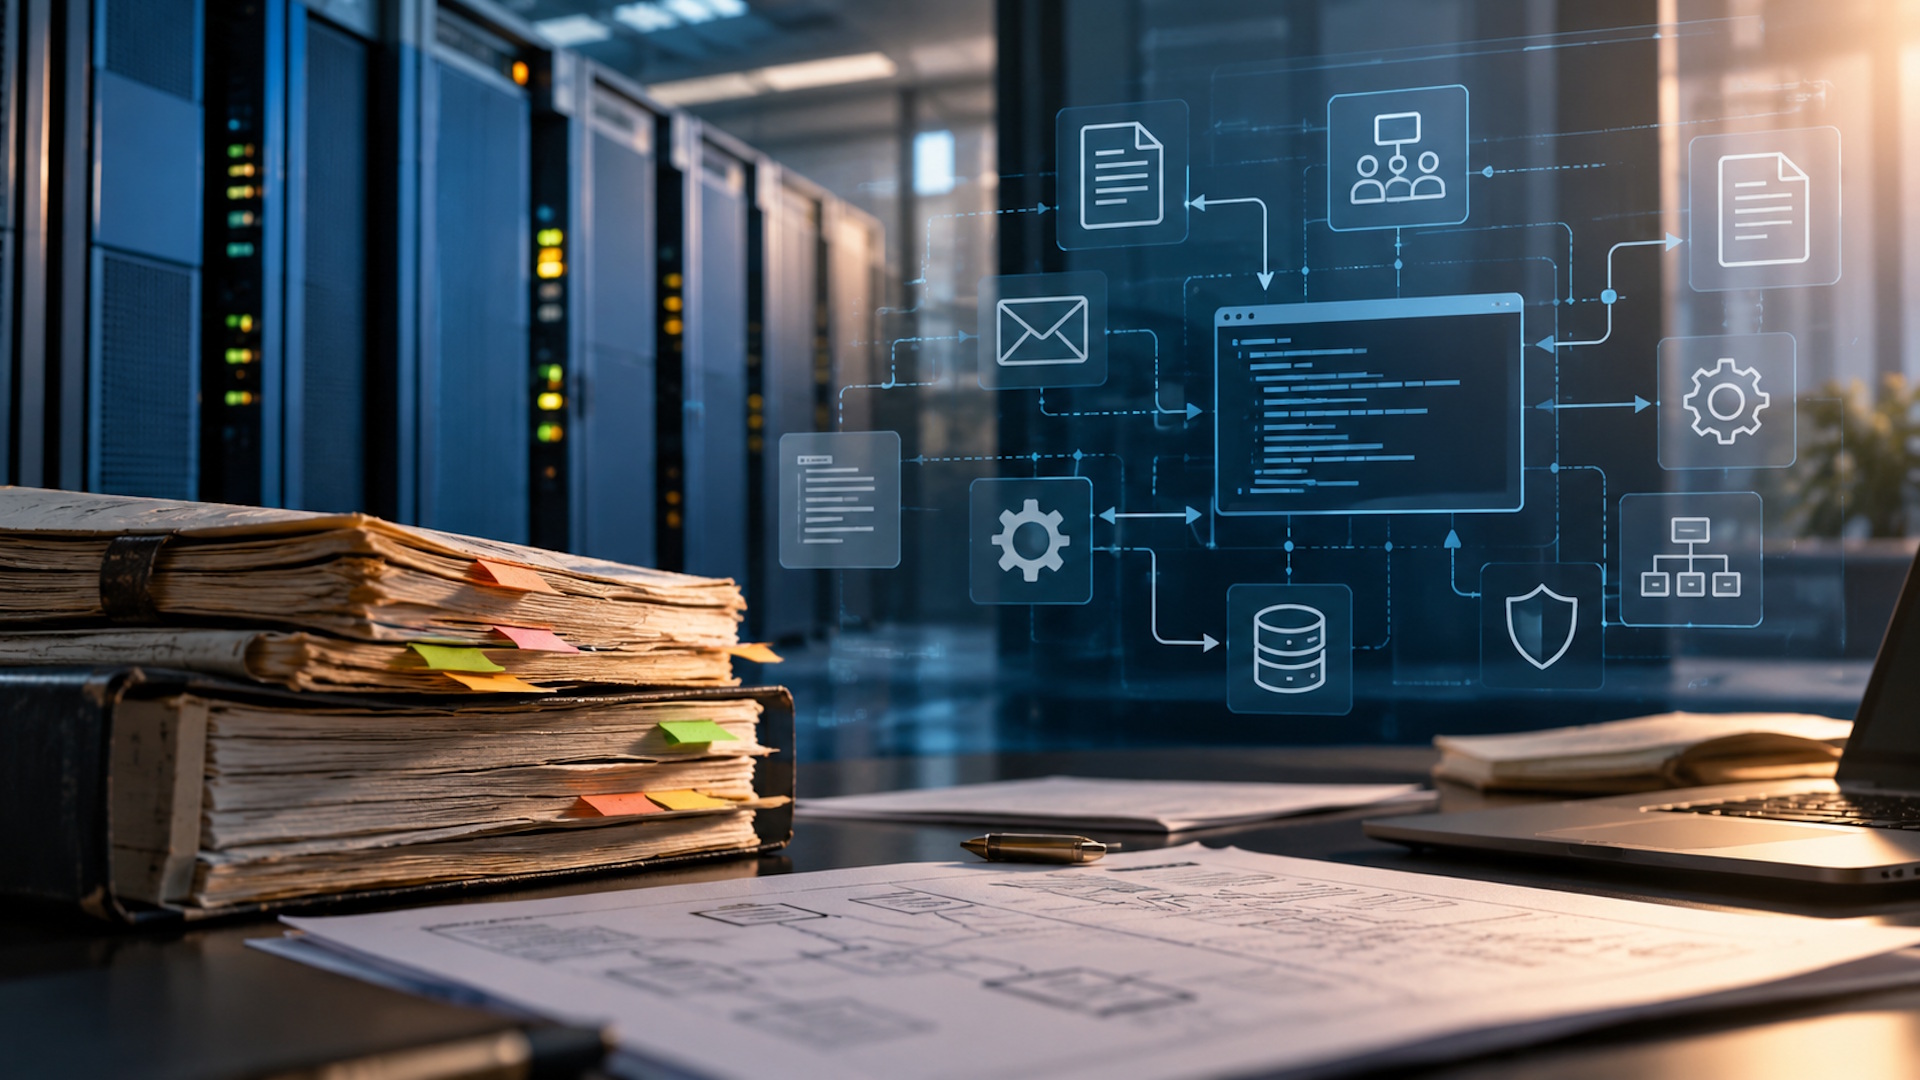
Der zweistufige Ansatz von Spec2COBOLRot: Zunächst erzeugt ein KI-Agent aus einer fachlichen Spezifikation ausführbaren COBOL-Code. Anschließend wird dieser anhand von Mustern aus realem Produktionscode schrittweise verändert und auf vorgegebene Komplexitätsmerkmale geprüft. Eigene KI-genierierte Darstellung nach Espinasse, Khelladi und Acher (2026).
Als Referenz verwendeten die Forscher 14 reale COBOL-Batchprogramme aus einer über Jahre weiterentwickelten Payroll-Anwendung des Industriepartners Sopra Steria. Die Programme umfassen zwischen 360 und 28.387 Source Lines of Code. Aus diesem Bestand leiteten die Forscher Zielwerte unter anderem für Programmgröße, Zahl der Paragraphen, zyklomatische Komplexität, GO TO-Anweisungen und Variablennutzung ab.
Für die Versuche wurden drei fachliche Szenarien aus Banking, Payroll und Versicherungen verwendet. Das Banking-Szenario bildet die nächtliche Verarbeitung von Transaktionen einschließlich Gebühren, Zinsen und Interbanken-Abstimmung ab. Beim Versicherungsszenario geht es unter anderem um die Neuberechnung von Prämien und die Schadenregulierung. Die Spezifikationen seien aus realen Anwendungsfällen abgeleitet und von einem COBOL-Experten validiert worden.
Die Kennzahlen stimmen – der Legacy-Code noch nicht
Die Ergebnisse zeigen zunächst, dass sich die strukturelle Komplexität der generierten Programme gezielt erhöhen lässt. Nach der „Degradation“ näherten sich die untersuchten Kennzahlen bei den drei Programmen weitgehend den aus dem realen Referenzbestand abgeleiteten Zielbereichen an.
Doch die Annäherung an bestimmte Kennzahlen reichte nicht aus, um durchgängig realistischen Legacy-Code zu erzeugen. Bei höheren Zielgrößen habe das verwendete Sprachmodell beispielsweise strukturell und semantisch ähnliche Paragraphen dupliziert, um vorgegebene Größen- und Komplexitätswerte zu erreichen. Die Schwellenwerte ließen sich damit zwar erfüllen. Ein solches Wachstum entspreche jedoch nicht der Art, wie reale COBOL-Anwendungen über längere Zeit größer und komplexer würden, schreiben die Autoren.
Auch die beteiligten Legacy-Experten erkannten Unterschiede. Die zunächst erzeugten Programme hätten sie als sehr sauber und damit teilweise als zu sauber für industriellen COBOL-Code bewertet. Nach der künstlichen Alterung seien zwar typische Legacy-Muster vorhanden gewesen. Andere Eigenschaften realer Bestände fehlten jedoch oder traten zu selten auf. Genannt werden unter anderem COPY Statements, bestimmte Formen der IF-Terminierung und REDEFINES. Insgesamt bewerteten die Experten die Verwendung realer Legacy-Muster als vielversprechenden ersten Schritt, die Ergebnisse aber noch als zu synthetisch, um die Vielfalt realer Legacy-Bestände vollständig abzubilden.
Auch die fachliche Funktion bleibt nicht automatisch erhalten
Ein weiteres Problem zeigte sich bei der funktionalen Äquivalenz. Das Forscher-Trio führte die Programme vor und nach der künstlichen Alterung mit denselben synthetischen Testdaten aus und verglich anschließend die erzeugten Dateien.
Auf der ersten untersuchten Komplexitätsstufe blieb das Ergebnis lediglich bei fünf von neun Durchläufen unverändert. Beim Versicherungsprogramm gelang dies in allen drei Versuchen. Beim Payroll- und beim Banking-Programm führten jeweils zwei von drei Durchläufen zu Unterschieden in sämtlichen Ausgabedateien. Die Autoren führen dies unter anderem darauf zurück, dass der Agent bei den Veränderungen bewusst nicht nach jeder einzelnen Iteration durch eine harte funktionale Prüfung eingeschränkt wurde. Für einen praktischen Einsatz halten sie eine engere Überprüfung nach jedem Schritt inzwischen für den besseren Ansatz.
Für die Bewertung KI-gestützter Modernisierungsverfahren ist dieser Befund relevant: Das Experiment zeigt, dass strukturelle Ähnlichkeit mit produktivem Legacy-Code und die Bewahrung des fachlichen Verhaltens getrennt betrachtet werden müssen.
Legacy-Komplexität hat eine Geschichte
Espinasse, Khelladi und Acher benennen selbst eine grundsätzliche Grenze ihres Ansatzes. Strukturelle Komplexität werde wesentlich von der Geschäftslogik bestimmt und sei zugleich durch über Jahrzehnte vorgenommene Patches und Änderungen geprägt. Das alleinige Ansteuern bestimmter Kennzahlen könne deshalb künstlich wirken.
Für künftige Arbeiten schlagen sie einen anderen Weg vor. Statt typische Legacy-Muster direkt in ein fertiges Programm einzubauen, könnte ein Wartungsplan Änderungen und Patches über mehrere Jahrzehnte simulieren. Ein „Legacy-Developer-Agent“ würde den Code dann schrittweise verändern und erweitern. Die Forscher erwarten davon potenziell realistischere Programme, weisen allerdings auch auf höhere Generierungskosten hin.
Die Studie liefert damit keinen Beleg dafür, dass KI für die Legacy-Modernisierung grundsätzlich ungeeignet wäre. Sie macht auf ein vorgelagertes Problem aufmerksam: Schon realistische Benchmarks für die Bewertung solcher Verfahren sind schwer herzustellen. Legacy-Komplexität lässt sich offenbar nicht einfach über Kennzahlen und Code-Smells rekonstruieren.
Die Aussagekraft des Experiments ist dabei begrenzt. Der Referenzbestand umfasst 14 Programme eines einzigen Industriepartners aus dem Payroll-Umfeld; zudem wurden nur wenige synthetische Programme aus drei Domänen untersucht. Die Autoren weisen selbst darauf hin, dass sich die Ergebnisse deshalb nicht ohne Weiteres auf andere Unternehmen, Branchen oder COBOL-Bestände übertragen lassen. (td)
Was ist die ASE?
Die ASE (International Conference on Automated Software Engineering) ist eine internationale wissenschaftliche Konferenz zur Automatisierung der Softwareentwicklung. 2026 findet sie zum 41. Mal statt und wird von IEEE (Institute of Electrical and Electronics Engineers) und ACM (Association for Computing Machinery), zwei international bedeutenden Fachorganisationen für Ingenieurwissenschaften und Informatik, getragen.
Nach Angaben der Veranstalter bringt die Konferenz Wissenschaftler und Praktiker aus Forschung und Industrie zusammen, die sich mit Methoden und Werkzeugen zur Automatisierung von Analyse, Design, Implementierung, Test und Wartung großer Softwaresysteme beschäftigen. Die ASE 2026 findet vom 12. bis 16. Oktober 2026 in München statt.